
Claude Code の subagent を108日間運用しました。2026年5月17日から9月2日までで、合計16体を作り、13体を消しました。
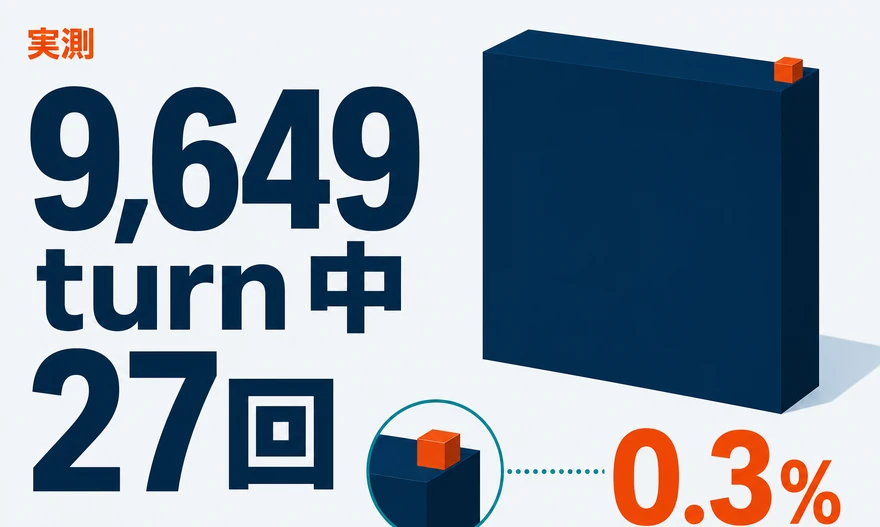
先に結論です。subagent は「本体に原理的にできないこと」だけに使ってください。 役割の一覧から作ると使われません。当メディアの環境では、6日間9,649ターンのうち Agent 呼び出しは 27回(0.3%) で、当時いた14体のうち 11体が一度も起動しませんでした。
この記事は、消した13体の理由と、残した3体の基準を実測つきで書いたものです。あわせて、コードレビュー用の定義ファイル最小構成も載せています。設計の提案ではなく、失敗した設計の記録です。
実測:作った数と、呼ばれた回数
| 集計 | 実数 |
|---|---|
| 作った agent 定義(108日間の累計) | 16体 |
| 消した agent 定義 | 13体 |
| 残っている agent | 3体 |
| 6日間のターン数 | 9,649 |
| うち Agent 呼び出し | 27回(0.3%) |
| 当時14体のうち起動0だった数 | 11体 |
振り分け役 router の起動 |
0回 |
一方で、ツール呼び出しの63%はシェル実行でした。中身は自作スクリプトのPython群です。
つまり実態はこうでした。振り分けの層を挟むより、本体が直接スクリプトを叩くほうが速い。 綺麗な役割分担の図を作ったものの、実際の作業はその図を通らずに流れていました。
消した13体と、その理由
2026年5月に「入口1体 + 振り分け役1体 + 専門14体」という構造を設計しました。職種と業務で割った、見た目の整った構成です。これが機能しませんでした。
消した理由は4種類に分けられます。
| 消した agent | 廃止理由 |
|---|---|
router(振り分け役) |
渡し先を決めるのは本体がやること。判断を下位モデルに委ねるのは逆流 |
secretary(秘書) |
「本体が兼任」と定義ファイル自身に書いてあった。役割が重複 |
scheduler(日数計算) |
経過日数を数えるだけ。grep 一発で終わる |
librarian(ファイル探索) |
ファイルの場所を特定するだけ。同上 |
| 職種で割った9体 | 役割は言えるが「本体より良くなる理由」が言えなかった |
scheduler と librarian が示しているのは、「できる」と「agentにすべき」は別だということです。 どちらも動きはしました。ただし1コマンドで終わる仕事に、別プロセスの起動と結果の受け渡しを足していたので、遅くなっただけでした。
secretary は設計時点で破綻していました。定義ファイルに「本体が兼任」と書いてある agent は、作った時点で使われないことが決まっています。定義を書いていて「本体でもできる」と書きたくなったら、その agent は作らないでください。
消した定義は削除せず git に残してあります。判断を間違えたときに戻せるようにしておくと、消す決断が軽くなります。
残した3体は何が違ったか
配置の基準は1つだけにしました。本体が同じ context の中でやるより良くなる理由が、言葉で言えるか。 言えないなら作りません。
| agent | 本体に原理的にできないこと | 起動実測 |
|---|---|---|
| 監査(auditor) | 独立性。 自分が書いたものを自分で監査しても、同じ見落としを繰り返す | 12 |
| 実装(coder) | context 分離。 試行錯誤の中間生成物を本体の文脈に載せない | 10 |
| 調査(researcher) | context 分離。 大量の取得結果ではなく、要点だけを返す | 3 |
3体とも理由が「独立性」か「context 分離」のどちらかです。どちらも本体が同じ会話の中でやると原理的に達成できません。 逆に言えば、この2つに当てはまらない仕事は本体でやったほうが速い、というのが108日間の結論でした。
組み込みの汎用 agent も併用しています(汎用21回・探索1回)。設計用の agent を自作する必要はありませんでした。 組み込みで足りました。
コードレビュー用の定義ファイル(最小構成)
残した3体のうち、監査に相当するものは定義ファイル1枚で作れます。読み取り専用のツールだけを与えるのが要点です。
---
name: code-reviewer
description: コードの変更を独立した観点でレビューする。実装した本人とは別に走らせる
tools: Read, Glob, Grep
---

変更されたコードを読み、次の順で報告する。

1. 動作を壊す不具合(再現条件を書く)
2. セキュリティ上の問題(該当行を引用する)
3. 読みにくさ・重複(直す価値があるものだけ)

推測で断定しない。確認できなかったことは「未確認」と書く。
問題が無ければ「問題なし」と1行で返す。
tools を読み取り専用に絞るのが重要です。書き込み権限を与えると、レビューのはずが勝手に直し始めて、何を指摘されたのかが分からなくなります。
この構成は実行検証済みで、意図的に脆弱性3件を仕込んだサンプルに対し、3件すべてを検出しました。ただし生成AIなので毎回同じ結果にはなりません。 出力形式を定義ファイルで固定すると振れ幅は抑えられますが、マージ判断は人の確認とセットで運用してください。
何体から始めるか
0体から始めてください。 本体でやって困ったときに、困った理由を1行で書けたら1体足す。それだけです。
当メディアの環境は最初に11体を一度に作り、108日後に3体になりました。先に役割の一覧を作ったのが間違いでした。 一覧は作れます。ただし一覧に載っていることと、実際にその単位で仕事が発生することは別です。
判断に迷ったら、次の2つだけ確認してください。
- 独立性が要るか。 自分でやると同じ見落としを繰り返す種類の仕事か
- 中間生成物を本体に載せたくないか。 大量の試行や取得結果を、結論だけにして返してほしいか
残した3体の定義ファイルを配布しています。監査・実装・調査の3体ぶんと、消した5種類の「作らないほうがよい例」、消すときに履歴を残す作法まで1枚にしてあります。顧客名・実案件・認証情報は含みません。ライセンスは自由です。
どちらも「いいえ」なら、本体でやったほうが速いです。そして多くの場合、答えは1コマンドのスクリプトです。 当メディアでツール呼び出しの63%がシェル実行だったのは、そういうことでした。
サブエージェント以外も含めた操作全体の内訳(サブエージェントは0.8パーセントでした)はClaude Code の使い方にあります。
訂正履歴
- 2026-09-02: 全面改稿。初版(2026-08-06)は「最小構成の作り方」だけを扱っていたが、108日間の運用で16体中13体を消したため、実測と判断基準を主題に変更した。定義ファイルの最小構成は節として残した
- 2026-08-25: 実行環境の記載を更新
よくある質問